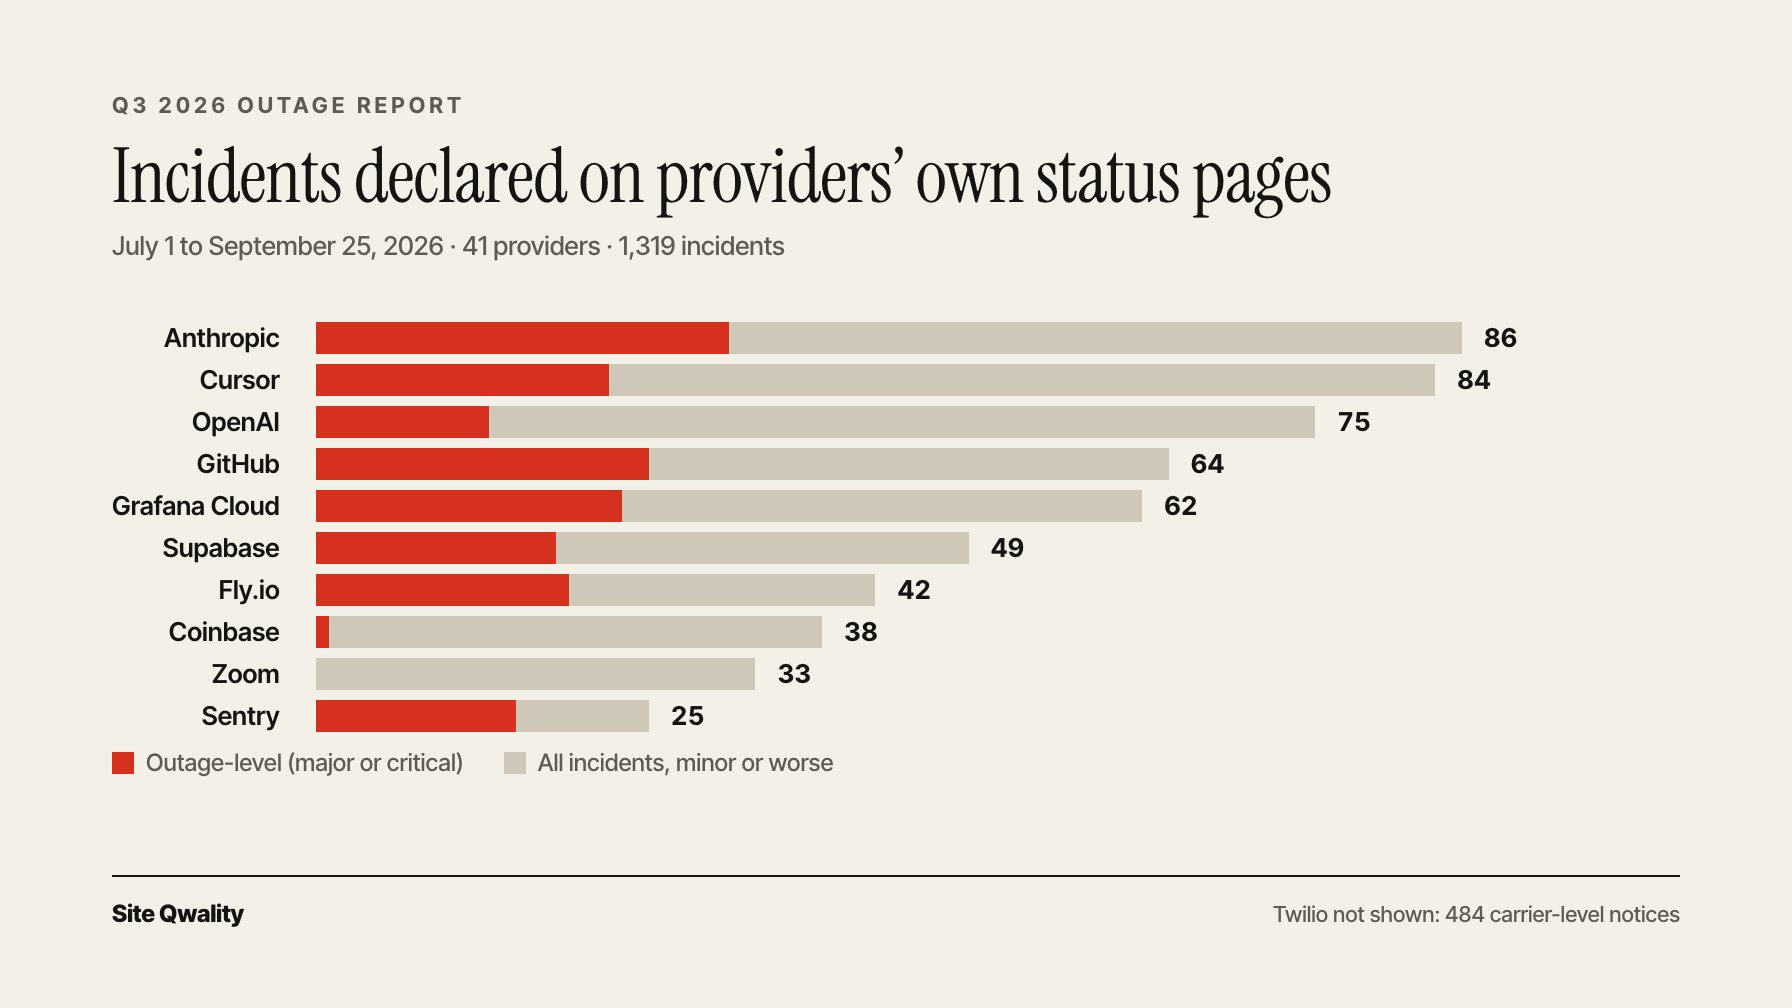
Jeder große Cloud-, KI- und SaaS-Anbieter veröffentlicht seine Incidents auf einer öffentlichen Statusseite. Wir haben alle Incidents erfasst, die 41 dieser Anbieter zwischen dem 1. Juli und dem 25. September 2026 gemeldet haben (87 Tage), und gezählt, was sie ihren eigenen Kunden mitgeteilt haben. So sah das dritte Quartal aus, direkt von den Anbietern.
Die wichtigsten Ergebnisse
- 1.319 Incidents in 87 Tagen. Die 41 Anbieter meldeten 1.319 Incidents, die als geringfügig oder schwerwiegender eingestuft waren. Allein auf Twilio entfallen 484, weil Twilio jede Zustellverzögerung auf Carrier-Ebene einzeln meldet. Ohne Twilio meldeten die übrigen 40 Anbieter 835.
- 280 waren Incidents auf Ausfallstufe. Der Anbieter stufte 280 Incidents als größeren oder kritischen Ausfall ein, nicht nur als eingeschränkte Leistung. 79 waren kritisch.
- Die drei größten KI-Tools meldeten zusammen 245 Incidents. Anthropic (86), Cursor (84) und OpenAI (75) meldeten zusammen etwa alle 8,5 Stunden einen Incident, 66 davon auf Ausfallstufe. Die Kategorie KI umfasst 7 der 40 Anbieter (ohne Twilio), aber 32 % ihrer Incidents.
- Anthropic meldete die meisten Incidents auf Ausfallstufe aller beobachteten Anbieter (31), gefolgt von GitHub (25), Grafana Cloud (23) und Cursor (22).
- GitHub meldete die meisten kritischen Incidents (12), vor Snowflake (10) und Sentry (7).
- Der typische Incident dauerte etwa anderthalb Stunden. Der mittlere Incident, ohne die Carrier-Hinweise von Twilio, lief 88 Minuten vom ersten Post bis zur Lösung. 64 % dauerten länger als eine Stunde.
- Ihr Anbieter hat Anbieter. Mindestens 10 Incidents von GitHub nannten im Titel ein KI-Modell eines Drittanbieters, von “Elevated errors on Fable 5 due to upstream provider” bis “Elevated rate of errors for OpenAI models provided by Copilot”.
Alle Anbieter, sortiert nach gemeldeten Incidents
“Ausfallstufe” bedeutet: Der Anbieter selbst hat den Incident als schwerwiegend oder kritisch eingestuft. Die Mediandauer reicht vom ersten Post bis zur Meldung der Lösung. Jeder Name verlinkt auf die Statusseite, von der die Daten stammen.
| Anbieter | Kategorie | Incidents | Ausfallstufe | Kritisch | Mediandauer |
|---|---|---|---|---|---|
| Twilio | Kommunikation | 484 | 2 | 0 | 5h 49m |
| Anthropic (Claude) | KI | 86 | 31 | 5 | 1h 04m |
| Cursor | KI | 84 | 22 | 5 | 1h 12m |
| OpenAI | KI | 75 | 13 | 3 | 1h 25m |
| GitHub | Entwicklertools | 64 | 25 | 12 | 1h 22m |
| Grafana Cloud | Entwicklertools | 62 | 23 | 6 | 2h 10m |
| Supabase | Cloud & Hosting | 49 | 18 | 4 | 2h 02m |
| Fly.io | Cloud & Hosting | 42 | 19 | 3 | 1h 19m |
| Coinbase | Zahlungen & Handel | 38 | 1 | 0 | 1h 11m |
| Zoom | Kommunikation | 33 | 0 | 0 | 2h 02m |
| Sentry | Entwicklertools | 25 | 15 | 7 | 3h 00m |
| Vercel | Cloud & Hosting | 25 | 10 | 1 | 1h 07m |
| DigitalOcean | Cloud & Hosting | 23 | 4 | 2 | 5h 29m |
| Snowflake | Cloud & Hosting | 22 | 17 | 10 | 1h 56m |
| CircleCI | Entwicklertools | 22 | 2 | 1 | 1h 20m |
| Notion | Produktivität | 21 | 5 | 0 | 1h 12m |
| Discord | Kommunikation | 17 | 16 | 2 | 1h 22m |
| Render | Cloud & Hosting | 16 | 10 | 4 | 58m |
| Jira | Entwicklertools | 15 | 6 | 3 | 2h 32m |
| MongoDB Atlas | Cloud & Hosting | 15 | 6 | 0 | 1h 50m |
| Datadog | Entwicklertools | 12 | 3 | 1 | 56m |
| Netlify | Cloud & Hosting | 10 | 4 | 1 | 26m |
| Mailgun | Kommunikation | 9 | 5 | 3 | 1h 22m |
| Linode | Cloud & Hosting | 9 | 0 | 0 | 2h 11m |
| Pinecone | KI | 8 | 6 | 1 | 2h 56m |
| Perplexity | KI | 8 | 5 | 3 | 1h 01m |
| Zapier | Produktivität | 8 | 2 | 0 | 3h 30m |
| npm | Entwicklertools | 7 | 1 | 0 | 1h 39m |
| 1Password | Identität & Sicherheit | 5 | 3 | 1 | 46m |
| Dropbox | Produktivität | 5 | 1 | 0 | 1h 54m |
| Runway | KI | 5 | 1 | 1 | 1h 01m |
| Weights & Biases | KI | 5 | 1 | 0 | 56m |
| Duo Security | Identität & Sicherheit | 4 | 0 | 0 | 9h 20m |
| New Relic | Entwicklertools | 2 | 1 | 0 | 1h 26m |
| Bitbucket | Entwicklertools | 2 | 0 | 0 | 1h 06m |
| Airtable | Produktivität | 1 | 1 | 0 | 1h 42m |
| Figma | Produktivität | 1 | 1 | 0 | 4h 11m |
| Atlassian Statuspage | Entwicklertools | 0 | 0 | 0 | – |
| HubSpot | Produktivität | 0 | 0 | 0 | – |
| Shopify | Zahlungen & Handel | 0 | 0 | 0 | – |
| Trello | Produktivität | 0 | 0 | 0 | – |
Zahlen mit Vorsicht lesen: Sie messen Transparenz ebenso wie Zuverlässigkeit
Die Zahl der Incidents zeigt, was ein Anbieter offengelegt hat. Und Anbieter legen sehr unterschiedlich offen. Twilio meldet einen eigenen Incident, sobald die SMS-Zustellung in ein Mobilfunknetz in einem Land langsamer wird: 484 Incidents in diesem Quartal, nur 2 davon auf Ausfallstufe. Shopify und Trello meldeten im Zeitraum gar keine Incidents, HubSpot nur Hinweise zur Information. Eine lange Liste auf einer Statusseite bedeutet oft, dass ein Anbieter kleine, klar abgegrenzte Probleme transparent macht. Sie bedeutet nicht, dass er weniger zuverlässig ist als ein ruhigerer Mitbewerber.
Vergleichen Sie Anbieter also innerhalb einer Kategorie. Gewichten Sie die Spalte mit den Incidents auf Outage-Level stärker als die Gesamtzahl, und betrachten Sie eine Null mit Skepsis. Die Zahlen bleiben nützlich: Sie sind die eigene Darstellung der Anbieter für das Quartal, und es gibt keine andere.
KI-Anbieter trugen die größte Last
Die Kategorie KI teilte sich in zwei Lager. Anthropic, Cursor und OpenAI meldeten 245 Incidents, die anderen vier KI-Anbieter, die wir aufnehmen konnten (Pinecone, Perplexity, Runway und Weights & Biases), zusammen 26. Die drei Großen sind auch die Tools, die Entwickler heute in Editoren, CI-Pipelines und Produkte einbinden. Ihre Incidents bleiben deshalb selten bei ihnen.
Viele dieser Incidents waren eingegrenzt: erhöhte Fehlerraten bei einem Modell, bei einer Oberfläche wie einer Desktop-App oder einem Coding-Agenten, oder in einer Region. Genau deshalb lässt sich so schwer darum herum planen. Ein Teilausfall bei dem einen Modell, das Ihr Feature aufruft, ist für Ihr Feature ein Totalausfall.
Der Anbieter Ihres Anbieters
Die Statusseite von GitHub zeigt, wie die Abhängigkeitskette heute verläuft. Mindestens 10 der 64 Incidents in diesem Quartal nannten im Titel ein KI-Modell oder einen KI-Anbieter von Drittanbietern, darunter eingeschränkte Verfügbarkeit von GPT-Modellen, Fehler bei Gemini und einen Incident beim Copilot-Modellanbieter mit Grok. DigitalOcean meldete Incidents für gehostete Llama-, DeepSeek- und Kimi-Modelle, und Twilio verzeichnete Flex-KI-Funktionen, die bei OpenAI in Timeouts liefen. Bei keinem dieser Unternehmen musste die eigene Infrastruktur ausfallen, damit Kunden Fehler sahen.
Was unsere eigenen Checks gesehen haben
Statusseiten zeigen, was ein Anbieter gemeldet hat. Um zu sehen, was ein Client tatsächlich bekommt, senden wir außerdem alle 10 Minuten eine nicht authentifizierte Anfrage von AWS us-east-1 an 20 Produktions-API-Endpoints, darunter GitHub, Stripe, npm, PyPI, Cloudflare und acht KI-Anbieter. Zwischen dem 13. August und dem 25. September ergab das rund 6.300 Checks pro Endpoint.
- 15 der 20 Endpoints beantworteten jeden Check wie erwartet.
- Die REST API von GitHub scheiterte bei 13 Checks, 12 mit HTTP 504 und 1 mit HTTP 500, verteilt auf acht Tage. Das ist winzig im Vergleich zu den 64 Incidents auf der Statusseite von GitHub, denn die meisten betrafen nur ein einzelnes Feature wie Actions oder ein Copilot-Modell, nicht die API, die jede Integration aufruft.
- Ein fehlgeschlagener Check ist nicht immer ein Ausfall. Die API von Perplexity beantwortete 193 unserer Checks mit HTTP 429, „too many requests“. Die API war erreichbar und hat uns per Rate Limit gedrosselt. Ein Monitor, der jeden unerwarteten Statuscode als Ausfallzeit wertet, hätte rund 32 Stunden Ausfall erfasst, die es nie gab.
- Der Rest waren vereinzelte Netzwerkfehler: je zwei Timeouts bei den APIs von Fastly und Meta Llama und eine fehlgeschlagene TCP-Verbindung zur API von Spotify.
Eine Antwort ist nicht dasselbe wie ein funktionierender Dienst. Unsere Checks sind bewusst nicht authentifiziert. Deshalb sehen sie die Fehler nicht, die erst auftreten, wenn Sie angemeldet sind und ein Modell aufrufen. Darum fallen unsere Werte höher aus als manche Angaben der Anbieter selbst: Die API von DeepSeek beantwortete jeden unserer Checks, während die eigene Statusseite für die APIs im etwa gleichen Zeitraum 99,66 % bis 99,89 % Uptime ausweist. Beides stimmt, und die zweite Zahl ist die, die für eine App zählt, die das Modell aufruft.
Diese Checks können Sie live auf unserem öffentlichen Status-Board verfolgen. Einzelne Dienste finden Sie auf unseren Ist es down?-Seiten.
Was Sie tun können
- Überwachen Sie den Endpoint, den Sie aufrufen, nicht die Statusseite des Anbieters. Eine Statusseite hinkt dem Ausfall hinterher und zeigt nur die Sicht des Anbieters. Warum, haben wir in Die Statusseite Ihres Anbieters ist der letzte Ort, an dem Sie erfahren, dass Sie down sind erklärt. Ein Check gegen die genaue API und das genaue Modell, von denen Sie abhängen, zeigt Ihnen, was Ihre Nutzer gleich sehen werden.
- Legen Sie vorab fest, was „gesund“ für jede Abhängigkeit bedeutet. Ein 401, ein 404 oder ein 429 kann eine völlig gesunde Antwort einer API sein, bei der Sie nicht authentifiziert sind. Konfigurieren Sie die erwarteten Codes, sonst bekommen Sie Alerts wegen Rate Limits.
- Planen Sie für eingegrenzte Ausfälle. Viele Incidents in diesen Daten betrafen ein Modell, ein Feature oder eine Region. Fallbacks auf dieser Ebene (ein zweites Modell, eine zweite Region, ein Retry in der Warteschlange) decken weit mehr reale Incidents ab als ein vollständiges Multi-Cloud-Failover.
- Erfahren Sie es vor Ihren Kunden. Im Observability Forecast 2026 von New Relic erfahren 42 % der Unternehmen von Störungen weiterhin durch manuelle Checks oder Kundenbeschwerden. Allein die Erkennung eines Ausfalls mit hoher Auswirkung dauert im Schnitt 41 Minuten (New Relic).
Überwachen Sie die APIs, von denen Ihr Produkt abhängt
Site Qwality Checks prüfen jeden Endpoint, auf den Sie sich verlassen, mit den Statuscodes, die Sie als gesund definieren. Sobald er nicht mehr antwortet, erhalten Sie einen Alert per Slack, E-Mail, SMS oder Webhook. Kostenlos starten, keine Kreditkarte erforderlich.
Kostenlos startenMethodik
- Quelle. Die öffentliche Statusseite jedes Anbieters, erfasst am 26. September 2026. Bei Seiten auf Atlassian Statuspage haben wir den Incident-Verlauf-Feed der Seite genutzt, der jeden Incident der letzten drei Monate auflistet. Bei Seiten auf incident.io haben wir den öffentlichen Incident-Feed der Seite genutzt.
- Zeitraum. Incidents, die zwischen dem 1. Juli und dem 25. September 2026 (UTC) begannen.
- Schweregrad. Statuspage-Impact-Level, wie der Anbieter sie gesetzt hat (minor, major, critical). Die Level von incident.io wurden so zugeordnet: degraded performance zu minor, partial outage zu major und full outage zu critical. „Outage-Level“ bedeutet major oder critical. Reine Hinweise und geplante Wartungen sind ausgeschlossen.
- Dauer. Vom Beginn des Incidents bis zu seiner Behebung, wie auf der Statusseite angegeben, auf die Minute genau. Incidents, die am 26. September noch offen waren, sind mitgezählt, fehlen aber in den Medianen.
- Welche Anbieter enthalten sind. Nur Anbieter, deren veröffentlichter Verlauf nachweislich den gesamten Zeitraum abdeckt. Nicht enthalten sind: Cloudflare, Fastly, Hugging Face, Together AI, DeepSeek, Mistral AI, xAI, Midjourney, Replicate, Auth0, Adyen und Intercom, deren Incident-Verlauf wir nicht maschinenlesbar abrufen konnten; sowie Cohere, Groq, ElevenLabs, Fireworks AI, Stability AI, Miro und Square, deren aktueller Verlauf auf der Statusseite erst nach dem 1. Juli beginnt, sodass ihre Zahlen unvollständig wären. SendGrid teilt sich die Statusseite mit Twilio und wird einmal gezählt, als Twilio.
- Unsere eigenen Checks. Pro Endpoint eine nicht authentifizierte HTTP-Anfrage alle 10 Minuten von AWS us-east-1, vom 13. August bis 25. September 2026. Die nicht authentifizierte Antwort jedes Endpoints (zum Beispiel 401 oder 404) ist dabei als gesund konfiguriert.
Nutzung dieser Daten
Sie dürfen diese Zahlen gern in Ihren eigenen Texten verwenden. Nennen Sie bitte „Site Qwality Q3 2026 Outage Report“ als Quelle und verlinken Sie diese Seite. Den vollständigen Datensatz gibt es als CSV-Download.