Automatisch aus Monitor-Alerts
Stellen Sie einen Service so ein, dass er automatisch einen Incident eröffnet, wenn ein verknüpfter HTTP-, Cron- oder Browser-Monitor ausfällt. Niemand muss mitten in der Nacht auf „Incident ausrufen" klicken.
Incidents ausrufen, verfolgen und schließen, ohne die Plattform zu verlassen. Schweregrade, strukturierte Updates und Verknüpfung mit betroffenen Services. HTTP-, Cron- und Browser-Monitore, die mit einem Service verknüpft sind, können Incidents automatisch eröffnen und bei Wiederherstellung lösen.
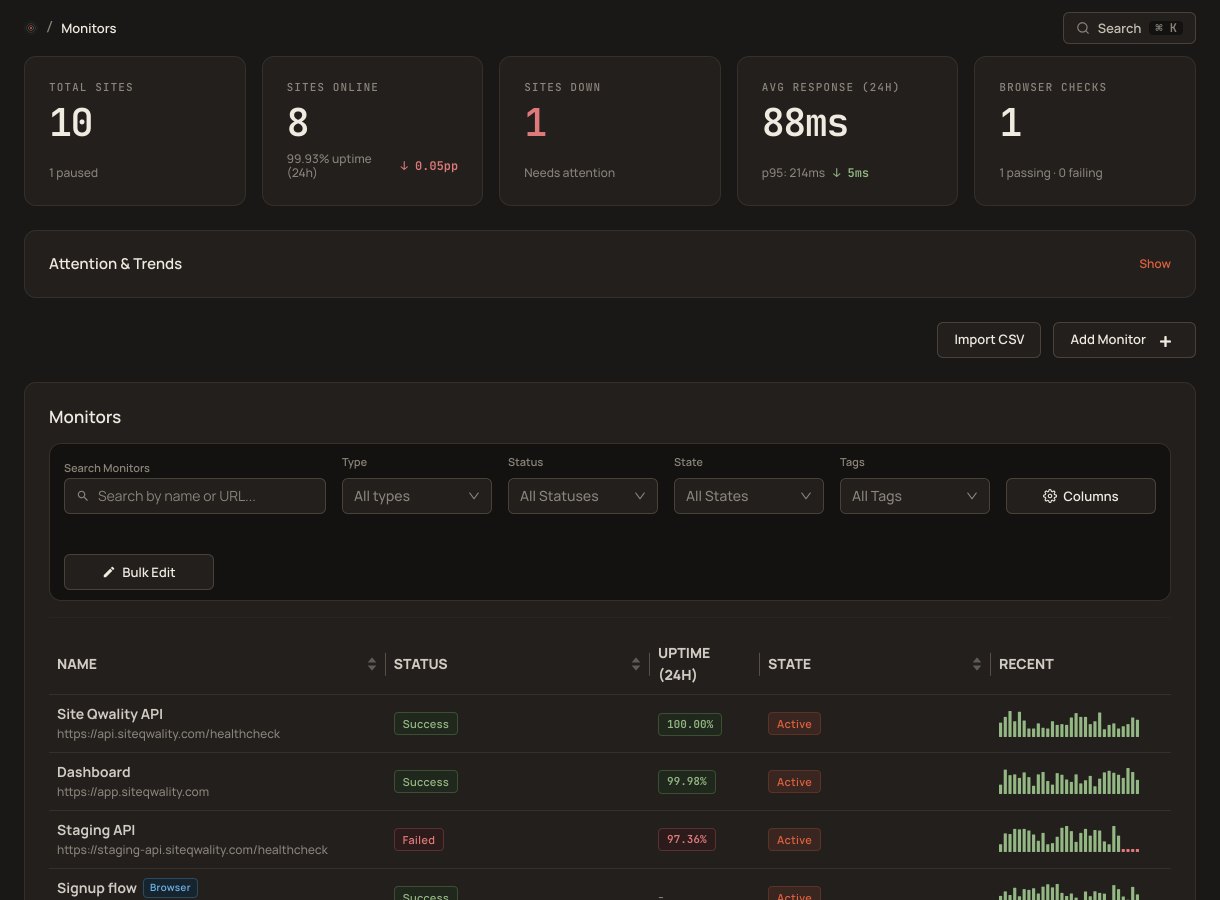
Jeder Incident hat einen Schweregrad, einen Status, eine Timeline mit Updates und den Service und die Monitore, die er betrifft. Die Eskalationsrichtlinie alarmiert beim Eröffnen Ihren Ingenieur in Bereitschaft; wenn Sie ihn veröffentlichen, sehen Ihre Nutzer ihn auf der Statusseite; Ihr Team postet das nächste Update, alles an einem Ort.
Stellen Sie einen Service so ein, dass er automatisch einen Incident eröffnet, wenn ein verknüpfter HTTP-, Cron- oder Browser-Monitor ausfällt. Niemand muss mitten in der Nacht auf „Incident ausrufen" klicken.
Incidents sind minor, major oder critical. Critical- und Major-Incidents alarmieren mit hoher Dringlichkeit, Minor-Incidents mit niedriger. P1 bis P4 werden nicht verwendet.
Posten Sie Updates durch Investigating, Identified, Monitoring und Resolved. Jedes Update erhält einen Zeitstempel und bleibt am Incident.
Veröffentlichen Sie einen Incident auf Ihrer öffentlichen Statusseite, oder lassen Sie einen Service seine automatischen Incidents auf einer Seite veröffentlichen, die Sie über die API festlegen. Komponenten der Statusseite folgen ihren Monitoren, nicht dem Incident.
Der Incident hält fest, ob er bestätigt oder gelöst wurde, wer ihn bestätigt hat und wann. Eine Bestätigung stoppt die Eskalationsrichtlinie.
Posten Sie Updates mit Zeitstempel durch Investigating, Identified, Monitoring und Resolved. Strukturierte Postmortem-Dokumente gibt es noch nicht.
Fällt ein mit einem Service verknüpfter Monitor aus, kann Site Qwality einen Incident mit dem Standard-Schweregrad des Service eröffnen, den Monitor verknüpfen, die Person in Bereitschaft über die Eskalationsrichtlinie des Service alarmieren und ihn auf der gewählten Statusseite veröffentlichen, bevor jemand ein Wort getippt hat. Sie ergänzen Kontext, statt den Ablauf anzustoßen.
Nach der Lösung bleibt die Timeline des Incidents erhalten: was Sie gepostet haben und wann. Strukturierte Postmortem-Dokumente gibt es noch nicht.
kürzestes Prüfintervall, das die Zeit bis zum Incident begrenzt
Schweregrade: minor, major und critical
Status: investigating, identified, monitoring und resolved
Incidents in jedem Plan; der kostenlose Tarif enthält 1 Person in Rufbereitschaft
Ja, für HTTP-, Cron- und Browser-Monitore, die mit einem Service verknüpft sind. Stellen Sie den Service auf automatische Incident-Erstellung, dann eröffnet Site Qwality einen Incident, wenn ein verknüpfter Monitor ausfällt, und löst ihn, wenn alle verknüpften Monitore wieder gesund sind. Im manuellen Modus rufen Sie Incidents selbst aus.
Incidents sind minor, major oder critical. Der Schweregrad bestimmt die Dringlichkeit, mit der die Eskalationsrichtlinie arbeitet: critical und major bedeuten hohe Dringlichkeit, minor niedrige, und die Benachrichtigungsregeln jeder Person entscheiden, wie sie kontaktiert wird. P1 bis P4 werden nicht verwendet.
Ein automatisch gelöster Incident postet ein Resolved-Update auf den Statusseiten, auf denen er veröffentlicht wurde. Komponenten der Statusseite folgen ihren Monitoren und kehren zu „Operational" zurück, wenn sich die Monitore erholen. Abonnenten erhalten eine E-Mail, wenn Sie ein Update über die Statusseite posten, nicht wenn sich ein Incident von selbst löst.
Jedes Update, das Sie posten (Investigating, Identified, Monitoring, Resolved), wird mit Zeitstempel und Ihrer Nachricht festgehalten. Die Timeline ist für Ihr Team sichtbar und, wenn veröffentlicht, für die Besucher Ihrer Statusseite.
Einen Dokumenttyp für Postmortems gibt es heute nicht. Halten Sie den Verlauf in der Incident-Timeline fest.
Uptime, Cron, Synthetic, Logs, RUM, Incidents und Statusseiten. Kostenlose Stufe bei jedem Produkt.