Prüfen Sie, was zählt
Prüfen Sie Statuscodes, Keywords, JSON-Werte und die finale URL. So erkennen Sie die defekte Seite, die trotzdem 200 zurückgibt.
Erfahren Sie sofort, wenn Ihre Website ausfällt. Sehen Sie, was fehlgeschlagen ist. Holen Sie die richtigen Personen dazu, mit allen Details auf einen Blick.
Wählen Sie aus 30 Standorten in 20 Ländern und Gebieten.
Kostenloser Tarif inklusive. Keine Kreditkarte erforderlich.

Stellen Sie sicher, dass Ihr Endpunkt die richtige Antwort liefert, nicht irgendeine. Halten Sie Ihre Checks präzise und Ihre Alerts nützlich.
Prüfen Sie Statuscodes, Keywords, JSON-Werte und die finale URL. So erkennen Sie die defekte Seite, die trotzdem 200 zurückgibt.
Prüfen Sie einen Fehler vom selben Standort oder aus einer anderen Cloud erneut. Verlangen Sie mehrere fehlgeschlagene Checks in Folge oder die Übereinstimmung mehrerer Standorte, bevor ein Alert rausgeht. Ein instabiler Endpunkt sendet eine Benachrichtigung, nicht eine pro Schwankung.
Senden Sie Alerts bei Ausfall und Wiederherstellung an Slack, Microsoft Teams, SMS oder E-Mail und alarmieren Sie, wer gerade in Rufbereitschaft ist.
Ein praxisnaher Blick auf die Informationen hinter einem Uptime-Alert.
Wählen Sie Endpunkt, Intervall und Assertions für den Dienst, auf den Sie angewiesen sind. Halten Sie die Checks passend zu dem, was Ihre Anwendung braucht.
Prüfen Sie von Standorten in AWS, Google Cloud und Microsoft Azure und legen Sie fest, wie viele fehlschlagen müssen, bevor Sie einen Alert erhalten.
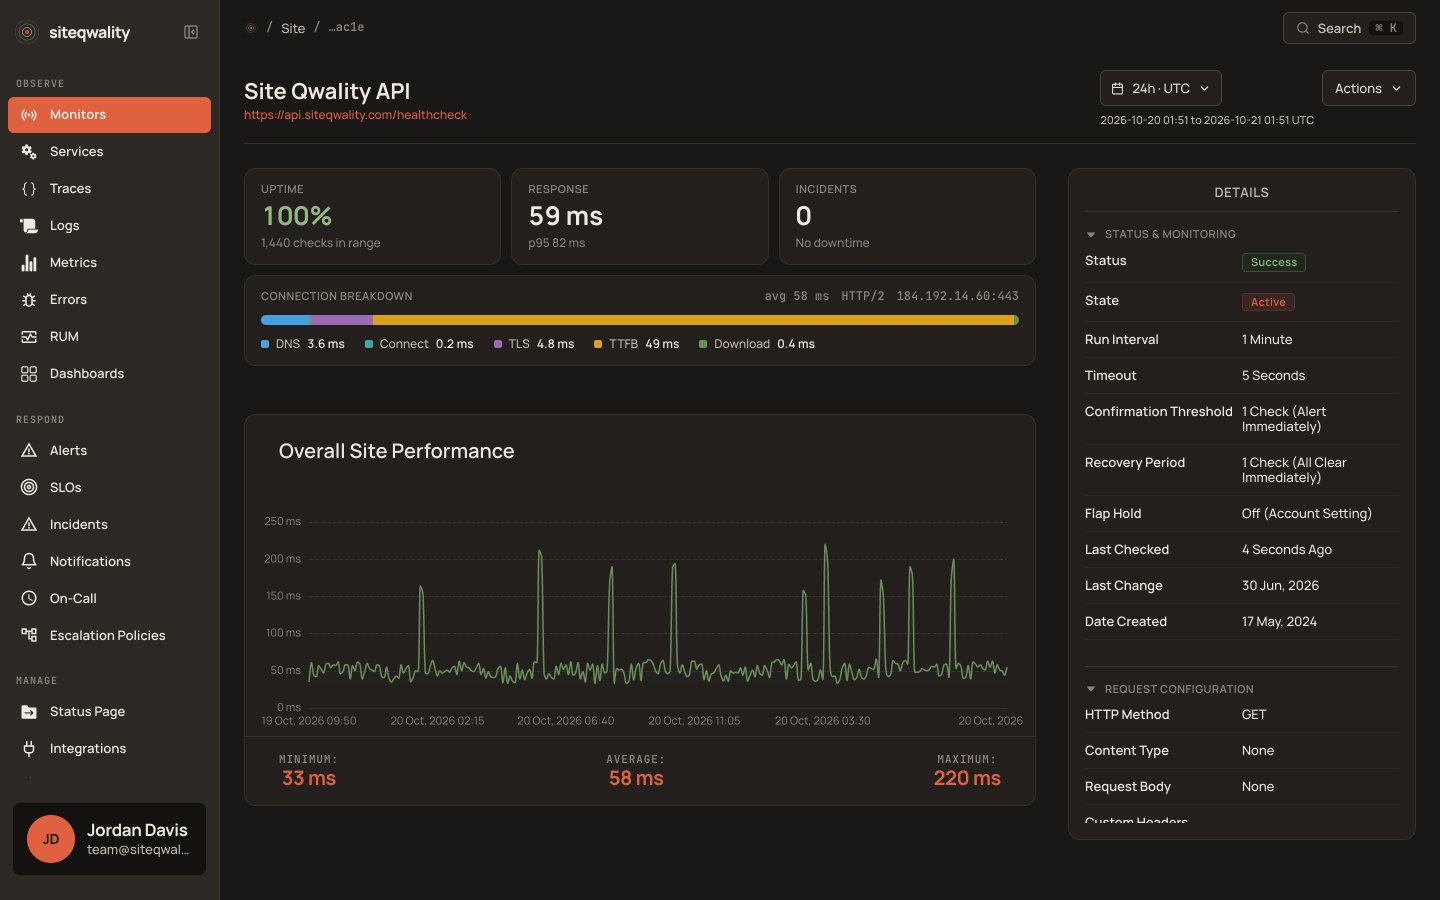
Sehen Sie sich die Phasen einer HTTP-Anfrage an, statt zu raten, ob die Verzögerung im DNS, in der Verbindung oder in der Anwendung entstand.
Zeiten pro Phase geben einer langsamen Antwort einen brauchbaren Ausgangspunkt.
Bringen Sie einen bestätigten Fehler zu Ihrem Team. Nutzen Sie Incidents und Statusseiten, damit Untersuchung und Kundenupdates verbunden bleiben.
Wählen Sie die Benachrichtigungskanäle und Reaktionseinstellungen, die zu Ihrem Dienst passen.
Ein Monitor mit 30-Sekunden-Intervall erkennt einen Ausfall beim nächsten Check. Sie legen fest, wie viele fehlgeschlagene Checks oder wie viel Wartezeit nötig sind, bevor jemand einen Alert erhält.
HTTP und HTTPS, TCP-Ports, ICMP-Ping, DNS-Einträge sowie das Ablaufdatum von Zertifikaten und Domains. Bei HTTP können Sie Statuscodes, Antwortzeiten, Keywords im Body und JSON-Pfade prüfen. Ein TCP-Check kann einen TLS-Handshake und eine erwartete Antwort verlangen, ein Ping-Check einen Schwellenwert für Paketverlust.
Vorübergehende Verbindungsfehler werden wiederholt, bevor etwas erfasst wird. Ein fehlgeschlagener Check kann vom selben Standort oder aus einer anderen Cloud erneut geprüft werden, bevor er zählt. Sie können mehrere fehlgeschlagene Checks oder Standorte vor einem Alert verlangen. Ein Monitor, der ständig zwischen Up und Down wechselt, sendet eine Benachrichtigung statt einer pro Wechsel.
Ohne Agent, ohne SDK, ohne DNS-Änderungen. Fügen Sie eine URL ein, und der erste Check läuft sofort. Monitore können Sie auch programmatisch über die REST API verwalten.
Ja. Der kostenlose Tarif enthält Uptime-Monitoring ohne Kreditkarte. Mehr Kapazität und kürzere Intervalle fügen Sie erst hinzu, wenn Sie wachsen.
Jeder Vergleich hat eine eigene Seite: Pingdom, UptimeRobot, StatusCake und Uptime Kuma.