Startseite
Preise
Plattform Blog Über uns Kontakt FAQ
Anmelden Kostenlos starten
Service-Katalog

Jeder Service,
mit einem Reaktionsplan.

Gruppieren Sie Ihre Monitore in die Services, die Ihr Team betreibt, und legen Sie dann fest, was bei einem Ausfall passiert: welche Eskalationsrichtlinie jemanden alarmiert, ob sich ein Incident von selbst eröffnet und auf welcher Statusseite er erscheint.

Free tier included No credit card 2-minute setup
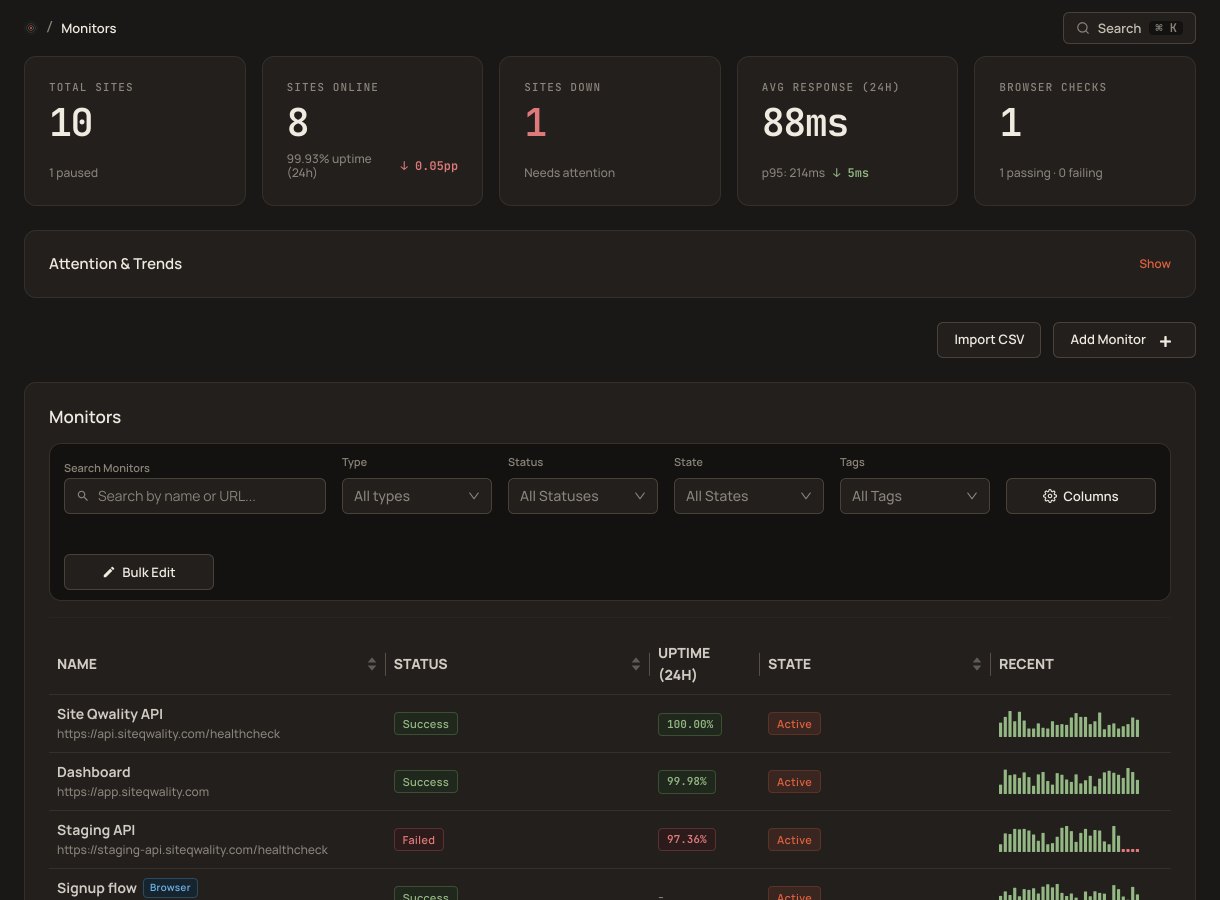
Site Qwality monitors list with status and sparklines

Denken Sie in Services, nicht in URLs.

Ein Service ist die Einheit, über die Ihr Team tatsächlich spricht: Payments, Checkout, Authentifizierung. Verknüpfen Sie seine HTTP-, Cron- und Browser-Monitore, geben Sie ihm eine Eskalationsrichtlinie und Incident-Einstellungen, und jeder Ausfall eines dieser Monitore folgt demselben Plan.

Services und Abhängigkeiten

Telemetrieidentitäten mit Verantwortlichen, Stufe, Rufbereitschaft und Runbooks verbinden. Endpunkt-RED, beobachtete Versionen, Bereitstellungen und Abhängigkeiten aus aufgezeichneten Traces untersuchen. Unvollständige Daten werden gekennzeichnet.

Logische Gruppierung

Gruppieren Sie HTTP-, Cron- und Browser-Monitore in benannte Services (Payments-API, Checkout, Authentifizierung), damit Ihr Team in Services denkt statt in einzelnen URLs und Ports.

Eskalation eingebaut

Geben Sie jedem Service eine Eskalationsrichtlinie. Ihre Stufen können Personen oder Rufbereitschaftspläne als Ziel haben, sodass ein Ausfall die Person in Schicht alarmiert, ohne dass jemand nachsehen muss.

Automatische Incidents

Lassen Sie einen Monitor-Ausfall einen Incident am Service eröffnen, mit dem Schweregrad Ihrer Wahl. Ausfälle innerhalb des Zusammenführungsfensters landen im offenen Incident, statt einen neuen zu starten.

Wiederherstellung schließt den Kreis

Sind alle Monitore hinter einem automatischen Incident wieder gesund, löst sich der Incident selbst und seine Eskalation stoppt, sodass niemand ans Schließen denken muss.

Anbindung an die Statusseite

Legen Sie über die API eine Statusseite für einen Service fest, und die automatisch eröffneten Incidents werden dort veröffentlicht, sodass Kunden das Problem sehen, ohne dass jemand es abschreibt. Eine Einstellung im Dashboard gibt es dafür noch nicht.

Service-Benachrichtigungen

Senden Sie die Incident-Benachrichtigungen eines Service an eine eigene E-Mail-Adresse, einen Webhook oder einen Slack-Kanal, zusätzlich zu den Personen, die die Eskalationsrichtlinie alarmiert. Ein Slack-Kanal als Ziel braucht ein Slack-Bot-Token, das im Ziel eingefügt wird.

Ein Plan pro Service

Ein Ausfall, der schon
weiß, wohin.

Jeder mit einem Service verknüpfte Monitor folgt dessen Plan. Der Incident öffnet mit dem richtigen Schweregrad, die Eskalationsrichtlinie alarmiert die richtige Person, und die eingestellte Statusseite erhält den Incident, ohne dass jemand im Moment entscheiden muss.

  • Incident-Erstellung: automatisch oder manuell
  • Ein Zusammenführungsfenster verhindert, dass ein Ausfall zehn Incidents eröffnet
  • Standard-Schweregrad minor, major oder critical pro Service
app.siteqwality.com / incidents
checkout · incident InvestigatingLIVE
SERVICEcheckout
SEVERITYMajor
FAILURES MERGED3
incident opened09:42
policy level 1 paged09:42
published to status page09:42
acknowledged09:46
Als Code verwalten

Den Katalog skripten
mit der REST-API.

Legen Sie Services an, verknüpfen Sie ihre Monitore und setzen Sie Eskalationsrichtlinie und Incident-Einstellungen über die REST-API. Bewahren Sie das Skript in Ihrem Repo auf, dann laufen Änderungen durch Ihren normalen Pull-Request-Prozess (geprüft, freigegeben, angewendet) statt durch Handarbeit in einer Oberfläche. Ein API-Schlüssel mit Scopes braucht read:services, um den Katalog zu lesen, und write:services, um ihn zu ändern; ein Schlüssel mit vollem Zugriff deckt beides ab.

  • Services vollständig über die REST-API anlegen, lesen, ändern und löschen
  • Monitore mit einem Aufruf an einen Service hängen
  • Diff-freundlich: Das PR-Review zeigt genau, was sich geändert hat
register a service$ curl -X POST https://api.siteqwality.com/service \
  -H "Authorization: Bearer $SQ_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"name":"payments-service","escalation_policy_id":"$EP","incident_creation_mode":"auto","default_incident_severity":"major"}'
1

Ort für Monitore, Eskalation und Incident-Einstellungen eines Service

0

manuelle Schritte, um einen Incident ans richtige Team zu leiten

3

Standard-Schweregrade für einen Service: minor, major oder critical

$0

kostenloser Tarif, Service-Katalog von Anfang an enthalten

FAQ

Ein Service ist eine benannte Gruppe von HTTP-, Cron- und Browser-Monitoren. Er hat eine Eskalationsrichtlinie, Incident-Einstellungen (Erstellungsmodus, Zusammenführungsfenster und Standard-Schweregrad), optionale Benachrichtigungsziele und optional eine Statusseite für seine Incidents, die über die API festgelegt wird. So denkt Ihr Team über Ihre Infrastruktur, unabhängig davon, wie sie physisch aufgebaut ist.

Das hängt vom Incident-Modus des Service ab. Im automatischen Modus öffnet sofort ein Incident; im manuellen Modus warten wir, bis Sie ihn ausrufen. Ein Ausfall innerhalb des Zusammenführungsfensters landet im bereits offenen Incident. Automatische Incidents lösen die Eskalationsrichtlinie des Service aus und erscheinen, falls eingestellt, auf seiner Statusseite.

Nein. Ein Service erfasst seine Monitore, seine Eskalationsrichtlinie und seine Incident-Einstellungen. Wer alarmiert wird, ergibt sich aus der Eskalationsrichtlinie und den Rufbereitschaftsplänen, auf die sie zielt. Abhängigkeiten zwischen Services werden nicht abgebildet.

Ja. Legen Sie über die API eine Statusseite für den Service fest, und die automatisch eröffneten Incidents werden dort veröffentlicht. Abonnenten der Statusseite erhalten für diese automatischen Incidents keine E-Mail.

Ja. Services, ihre verknüpften Monitore und ihre Benachrichtigungsziele werden alle über die REST-API verwaltet, sodass ein Skript in Ihrem Repo den Katalog mit dem abgleichen kann, was Sie betreiben.

Kostenlos starten. Keine Kreditkarte.

Uptime, Cron, Synthetic, Logs, RUM, Incidents und Statusseiten. Kostenlose Stufe bei jedem Produkt.